


质量追溯需要记录,但不是记录越多越好
一、记录焦虑,正在把追溯系统变成数据垃圾场
我见过太多工厂在追溯这件事上走弯路,而且走的是同一条弯路。最典型的场景是:老板开完一个质量会议,拍桌子说“以后所有环节都要留痕,出了问题必须能查到人”。于是IT部门连夜上线追溯模块,产线上每个工位加扫码枪,每道工序加电子表单,参数、时间、人员、设备、批次、来料、环境温湿度,能采的全采。半年后数据量涨到几十个TB,但真出了一批客诉,质量经理坐在电脑前查了四个小时,愣是没定位到是哪台设备哪个班次出的问题。
这就是我说的“记录焦虑”——把追溯等同于“什么都记”,以为记录维度越多、数据量越大,追溯能力就越强。实际上恰恰相反。追溯的本质是回答一个具体问题:“这个缺陷从哪来?”如果你的记录体系不能在三十分钟内回答这个问题,那记录再多也是负担。
我见过一家做精密冲压的工厂,上了追溯系统之后,每件产品关联了87个数据字段,从原材料炉号到模具保养记录全都有。听起来很完备。但他们的质量工程师告诉我,真正查问题时,最常用的只有4个字段:冲压设备编号、模具编号、生产时间窗口、操作班组。剩下的83个字段,一年用不到一次,却占用了大量存储成本和录入时间。产线操作工每班要多花25分钟填表单,怨声载道。
问题出在哪?出在追溯的起点搞错了。正确的逻辑是:先定义你要回答哪些追溯问题,再决定记录什么。而不是反过来,先拼命记录,再指望数据里能挖出答案。
二、追溯的起点,是一张“问题清单”,不是一张“数据清单”
我通常建议客户在做追溯规划时,先做一件看起来很简单但极其关键的事:列出过去12个月实际发生的质量异常,把每一个异常对应的追溯问题写下来。
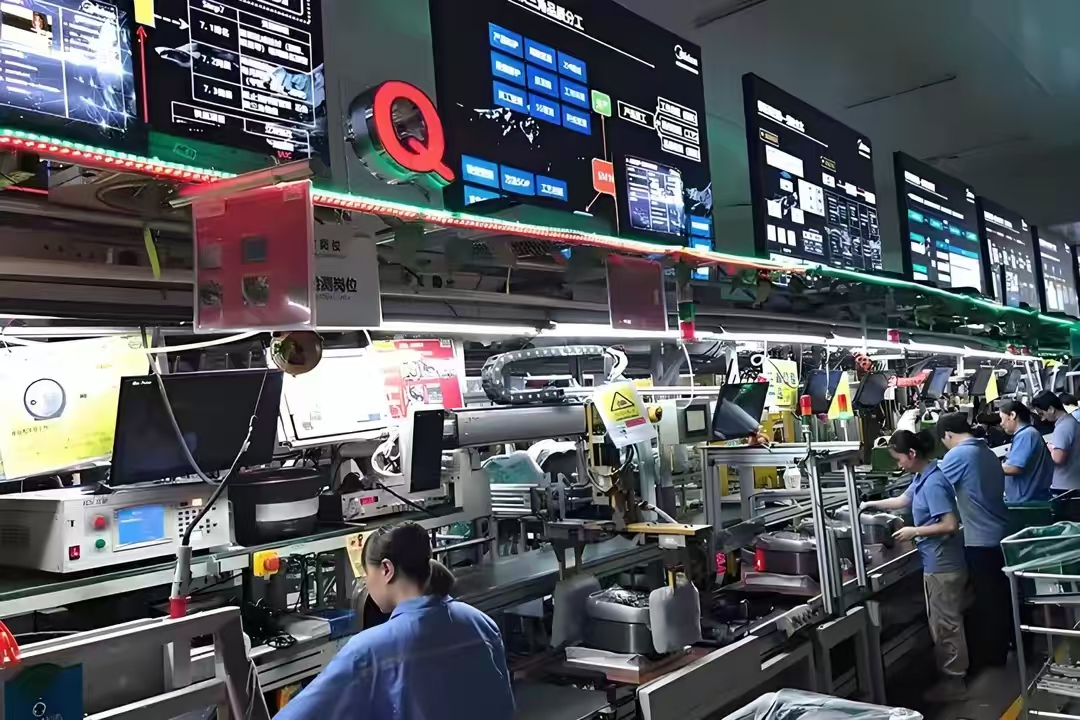
比如:客户投诉某批次产品尺寸超差0.05mm,需要追溯到哪台冲床、哪套模具、哪个时间段的来料批次。比如:某批产品在装配环节发现螺纹孔滑牙,需要追溯到攻牙工序的丝锥更换记录和润滑条件。比如:某批产品盐雾测试不合格,需要追溯到电镀线的槽液浓度和电流密度参数。
你会发现,真正需要追溯的问题,通常不超过20个场景。而这20个场景涉及的数据字段,加起来可能只有30到40个。跟你动辄记录上百个字段相比,精简了60%以上。
这里有一个关键判断:追溯记录的价值不在于“有”,而在于“准”和“快”。一条记录如果不能在特定追溯场景中被检索到、被关联上、被用来做判断,它就是无效记录。无效记录不仅浪费存储,更糟糕的是它会稀释有效信息——当数据库里塞满了无关字段,查询逻辑会变复杂,索引效率会下降,最终导致真正要查的时候查不出来。
科创致远在给客户做追溯方案时,有一个做法我觉得值得参考:他们不急着上采集硬件,而是先花两周时间跟质量部门一起梳理“追溯问题树”。把每个质量缺陷类型作为根节点,往下拆解需要回答的问题,再往下拆解需要的数据字段。这样倒推出来的记录清单,通常只有客户最初设想的40%左右,但追溯命中率反而更高。
适用条件:这套方法适用于产品品类相对稳定、质量缺陷模式有历史数据可循的制造企业。如果你做的是多品种小批量、工艺路线频繁变动的场景,问题清单需要按产品族分别梳理,工作量会大一些,但逻辑不变。
不适用条件:如果你所在的行业有强制性法规追溯要求(比如医疗器械UDI、航空零部件NADCAP),那法规规定的字段一个都不能少,不在本文讨论的“精简”范围内。精简的是你自己额外加的那些“以防万一”的字段。
三、三个数据点,帮你判断记录是不是“过量”了
怎么判断你的追溯记录是不是记多了?我给三个可量化的判断指标。
第一个指标:单件产品关联的数据字段数。如果你做的是离散制造,单件产品关联字段超过50个,大概率有冗余。汽车零部件行业的一级供应商,典型追溯字段在25到35个之间。超过这个数,要么是你的工艺确实特殊,要么就是记了太多“反正存着也不贵”的字段。存储不贵,但查询贵、维护贵、录入贵。
第二个指标:追溯查询平均耗时。从输入查询条件到得到可行动的结论,如果超过30分钟,说明你的数据关联设计有问题。我见过一家电子组装厂,他们的目标是“15分钟内定位到不良品的产生工位”。做到这个水平,产线组长就能现场判断要不要停线,而不是等质量工程师慢慢查。
第三个指标:无效字段占比。随机抽100个记录字段,统计过去6个月中被实际用于追溯查询的比例。如果低于30%,说明你的记录策略需要重新审视。这个数据不需要精确统计,让IT部门拉一下查询日志就能估算。
还有一个更直观的信号:产线操作工对录入工作的抵触程度。如果操作工需要额外花超过10分钟/班次来填追溯表单,你就要警惕了。超过15分钟,录入质量一定会下降——漏填、错填、随便填,最后追溯系统里的数据可信度崩塌。我见过一家注塑厂,操作工为了赶产量,扫码枪对着同一个二维码连扫五次,把五个不同批次的记录全填成一样的数据。这种追溯系统,有不如没有。
科创致远的实施经验里有一条:追溯录入动作应该嵌入到操作工原有的工作流中,而不是额外增加一个步骤。比如扫码枪集成到原有MES操作界面里,操作工本来就要扫产品条码报工,追溯字段作为报工的前置条件自动弹出,填完才能报工。这样操作工的额外时间控制在3分钟以内,数据质量反而更好。
四、可执行建议:两步走,先把追溯“做窄”,再“做深”
如果你现在正被追溯记录过多的问题困扰,我建议分两步走。
第一步:做一次“追溯断舍离”。拉上质量、生产、IT三个部门,花半天时间,把现有追溯系统的所有字段列出来,逐个问三个问题:这个字段对应哪个具体的追溯问题?过去半年有没有被实际用于查询?如果不记这个字段,最坏后果是什么?三个问题有两个答不上来,就标记为“可删除”。先别急着删,把标记结果跑一个月,看看有没有人反馈“这个字段不能删”。通常你会发现,80%的标记字段根本没人关心。然后分批下线,第一批先停掉那些纯人工录入、无自动采集、且查询日志为零的字段。
第二步:建“追溯问题-数据字段”映射表。把前面梳理的20个追溯场景,每个场景对应到具体的数据字段和查询路径。这张表就是你的追溯系统设计文档。以后任何人提出“要不要加个新字段”,先问:加到哪个追溯场景里?如果加不进去,就不加。这张表每季度评审一次,根据实际发生的质量异常更新。
这两步做完,你的追溯系统数据量可能减少一半以上,但追溯命中率和查询速度会明显提升。省下来的存储成本是小事,省下来的产线录入时间和质量工程师的查询时间,才是真正的收益。
最后说一个容易被忽略的点:追溯记录不是越细越好,但关键字段的精度必须够。比如时间戳,如果你的追溯场景需要区分不同班次,时间戳精度至少要到秒级,而且设备时钟必须定期校准。我见过因为设备时钟偏差15分钟导致追溯定位到错误班次的案例。记录字段可以少,但保留下来的字段,采集精度、采集频率、时钟同步必须做到位。
适用条件:这套“先做窄再做强”的方法,适用于已经上线了追溯系统但效果不达预期的企业,也适用于正准备上追溯系统的企业。前者做减法,后者避免走弯路。
不适用条件:如果你所在的行业处于强监管环境,且监管方对追溯数据字段有明确清单要求,那不在本文讨论范围内。本文针对的是企业出于自身质量管理需要而自主设计的追溯体系。
回到开头那个判断:质量追溯需要记录,但不是记录越多越好。记录的目的是回答具体问题,不是制造数据安全感。把追溯问题想清楚,记录自然就精简了;记录精简了,追溯反而更快更准。这个账,做采购决策的人应该算得过来。
 产品方案
 预约演示
 价格咨询