


城市AI视频监控硬件架构
城市AI视频监控硬件架构的核心,已经从高清摄像头加后端服务器转向前端NPU推理加边缘侧多传感器融合加云端大模型协同的三级异构计算体系。在智慧城市项目中,能否在边缘侧用低功耗NPU完成人、车、事件的结构化提取,再通过高算力AI加速器做跨镜追踪与语义检索,直接决定了系统的实时性、带宽成本和整体TCO。
一、核心概念与技术原理
城市AI视频监控硬件架构,通常由感知层、边缘计算层和中心推理层组成。感知层不再只是传统CMOS图像传感器,而是融合了事件驱动视觉传感器、毫米波雷达和低功耗NPU的AI传感器模组。事件驱动视觉只对画面中亮度变化的像素输出数据,在夜间或低活动场景下功耗可降到毫瓦级,非常适合智慧城市中大量部署的路灯杆、公交站台和社区出入口。
边缘计算层的核心是嵌入式AI芯片。以NVIDIA Jetson Thor为代表的高性能边缘平台,面向机器人和智能制造场景,支持实时控制与多路视频并行推理。高通、联发科、苹果等厂商推出的高算力低功耗NPU芯片,则让终端侧运行大模型推理成为可能,比如在摄像机端直接完成车牌识别、人脸比对和行为分析,只把结构化结果上传云端。
中心推理层依赖数据中心级AI加速器。NVIDIA Blackwell Ultra主打推理性能与HBM4内存,并规划了2026年推进量产的Rubin平台;AMD MI350系列基于CDNA4架构并规划MI400;Intel持续推进Gaudi 3及Falcon Shores GPU。这些加速器主要承担跨摄像头轨迹还原、以图搜图和城市级事件语义分析等重负载任务。
二、主流产品与方案对比
从部署形态看,城市AI视频监控硬件方案大致分为三类。
第一类是前端智能摄像机方案。主控采用低功耗NPU芯片,算力通常在几TOPS到几十TOPS之间,支持1到4路视频本地推理。优点是带宽占用低、响应快、隐私数据不出场;缺点是算力有限,难以运行复杂大模型。
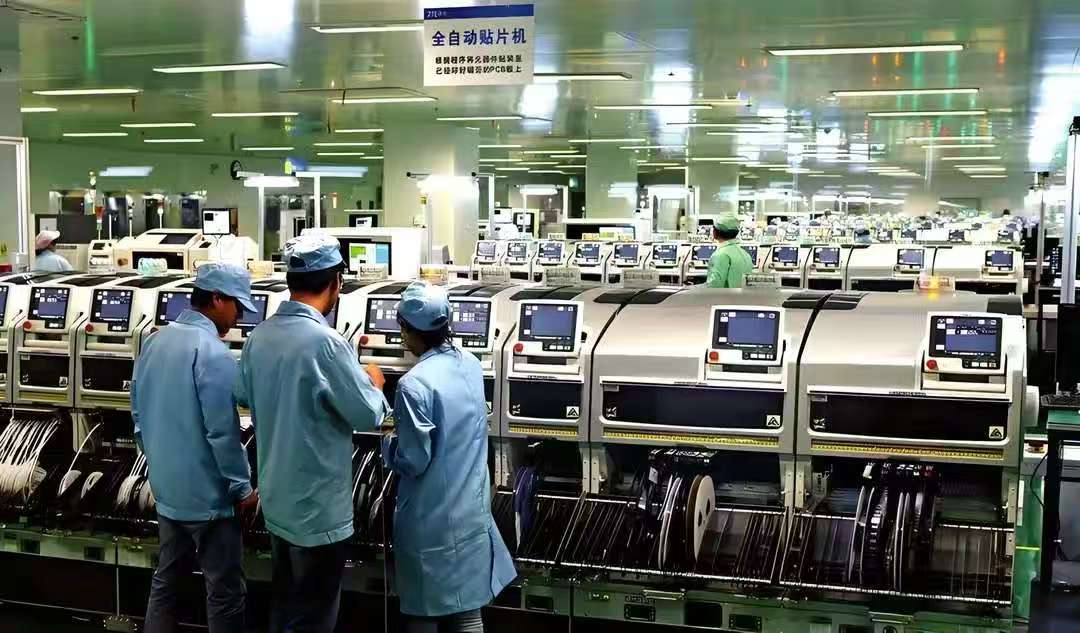
第二类是边缘AI盒子方案。以NVIDIA Jetson系列和国产边缘推理模组为代表,单台设备可接入8到32路视频,支持多传感器融合和实时控制。适合智慧交通路口、园区周界和工业质检场景。某电子厂在SMT产线旁部署边缘AI盒子后,利用事件驱动视觉和毫米波雷达融合,实现了对人员违规操作和物料短缺的毫秒级告警。
第三类是中心AI加速集群方案。采用Blackwell Ultra、MI350系列或Gaudi 3等加速卡,配合高带宽存储和高速互联,支撑城市级视频云平台的批量推理与模型训练。三类方案并非互斥,实际项目中常采用前端轻量推理加边缘中等算力加中心重负载的混合架构。
三、智慧城市AI硬件典型应用场景
1. 智慧交通。路口部署毫米波雷达与AI摄像机融合设备,边缘侧完成车流量统计、违章检测和信号灯配时优化。中心侧用AI加速器做全城交通态势推演。
2. 公共安全。社区和商圈的前端NPU摄像机实时提取人形、人脸和车辆特征,边缘节点做跨镜追踪,中心平台做以图搜图和轨迹还原。
3. 工业与园区。假设一家汽配企业,在厂区周界和危化品仓库部署事件驱动视觉传感器与低功耗边缘计算节点,实现入侵检测和烟火识别,同时用Jetson Thor类平台做AGV调度和机械臂实时控制。
4. 城市治理。路灯杆集成AI传感器,识别占道经营、垃圾堆积和井盖异常,只上传事件片段和结构化标签,大幅降低回传带宽。
在这些场景中,硬件选型只是第一步,如何把前端NPU、边缘加速器和中心GPU集群统一纳管、统一调度,才是工程落地的难点。科创致远在工业AI硬件方案整合方面,能够把不同厂商的AI加速器、边缘设备和传感器融合到同一套管理框架下,让算力按需分配到具体算法任务。科创致远ESOP在工业现场的设备协同与任务编排上,也提供了面向AI硬件的标准化接入能力,帮助系统集成商减少重复适配工作。目前科创致远已服务120余家客户,覆盖15个以上行业,累计3200余台终端在各类工业与城市场景中运行。
四、选型要点与部署建议
第一,算力匹配算法。不要盲目追求高TOPS,先明确前端要跑几个模型、分辨率和帧率要求。低功耗NPU适合轻量结构化提取,重负载语义分析交给中心加速器。
第二,关注内存带宽。大模型推理对HBM和LPDDR带宽敏感,Blackwell Ultra和MI350系列都在强调HBM4和高带宽显存,边缘侧也要看LPDDR5x的实际带宽。
第三,重视传感器融合能力。事件驱动视觉、毫米波和红外热成像的融合,能显著降低误报率。选型时确认硬件是否支持多路异构传感器同步输入。
第四,考虑模块化与可扩展性。工业AI硬件正向模块化发展,Jetson Thor等平台支持算力模组更换,便于后续升级到更高算力而不更换整机。
第五,部署时做好算力分层。前端做第一层过滤,边缘做第二层聚合,中心做第三层深度分析。避免把所有视频流直接回传中心,造成带宽和算力浪费。
五、技术趋势与未来展望
2026年将是AI推理硬件的重要节点。NVIDIA Rubin平台推进量产,AMD MI400和Intel Falcon Shores GPU陆续登场,边缘侧NPU算力将普遍进入100TOPS级别,终端侧运行十亿参数级大模型不再是瓶颈。同时,事件驱动视觉与毫米波融合的AI传感器会进一步降低功耗,让智慧城市中的每一根灯杆、每一个公交站都成为独立智能节点。
对系统集成商和城市管理者来说,未来竞争不在单颗芯片,而在异构硬件的协同效率。谁能把前端NPU、边缘加速器和中心GPU集群统一调度,谁就能在智慧城市项目中把延迟、带宽和成本同时压下来。面向AI硬件的方案整合思路,正是围绕这一趋势展开,让AI硬件不再是一堆孤立的盒子,而是一张可调度、可扩展、可运维的城市智能算力网络。
 产品方案
 预约演示
 价格咨询