


工厂AI推理服务器选型与部署
工厂AI推理服务器选型与部署,核心结论是:不要先看GPU型号,而要先算清产线节拍、模型精度和功耗预算这三笔账,再决定用数据中心级推理服务器还是边缘AI盒子。
一、行业背景与发展现状
2025年到2026年,工厂AI硬件正在经历一轮明显的代际切换。NVIDIA发布Blackwell Ultra(B300)并公布Rubin架构路线图,主打推理性能与HBM4内存,计划2026年推进Rubin平台量产;AMD推出MI350系列(CDNA4架构)并规划MI400;Intel推进Gaudi 3及Falcon Shores GPU。与此同时,高通、联发科、苹果等推出高算力低功耗NPU芯片,让终端侧大模型推理成为可能。工业AI硬件也在向模块化、实时控制方向发展,NVIDIA Jetson Thor等平台面向机器人与智能制造,AI传感器则融合事件驱动视觉、毫米波与低功耗边缘计算,用于工业检测与可穿戴设备。对工厂来说,推理服务器不再是"买一张卡"那么简单,而是一套从供电、散热到模型编译的系统工程。
二、核心概念与技术原理
工厂AI推理服务器,本质是把训练好的模型部署到产线侧,对图像、振动、温度、声音等信号做实时判断。它和训练服务器最大的区别在于:训练看吞吐,推理看延迟和能效。关键指标包括每秒推理次数、首帧延迟、功耗比和内存带宽。以Blackwell Ultra为例,HBM4内存带来的带宽提升,直接决定了大模型在产线侧能否做到毫秒级响应。AMD MI350系列采用CDNA4架构,在FP8和FP16推理上做了针对性优化;Intel Gaudi 3则强调以太网互联的扩展性。边缘侧,NPU芯片把推理功耗压到几瓦到几十瓦,适合质检工位、AGV和机械臂末端。理解这些差异,才能避免"用训练卡做推理"的浪费。
三、主流产品与方案对比
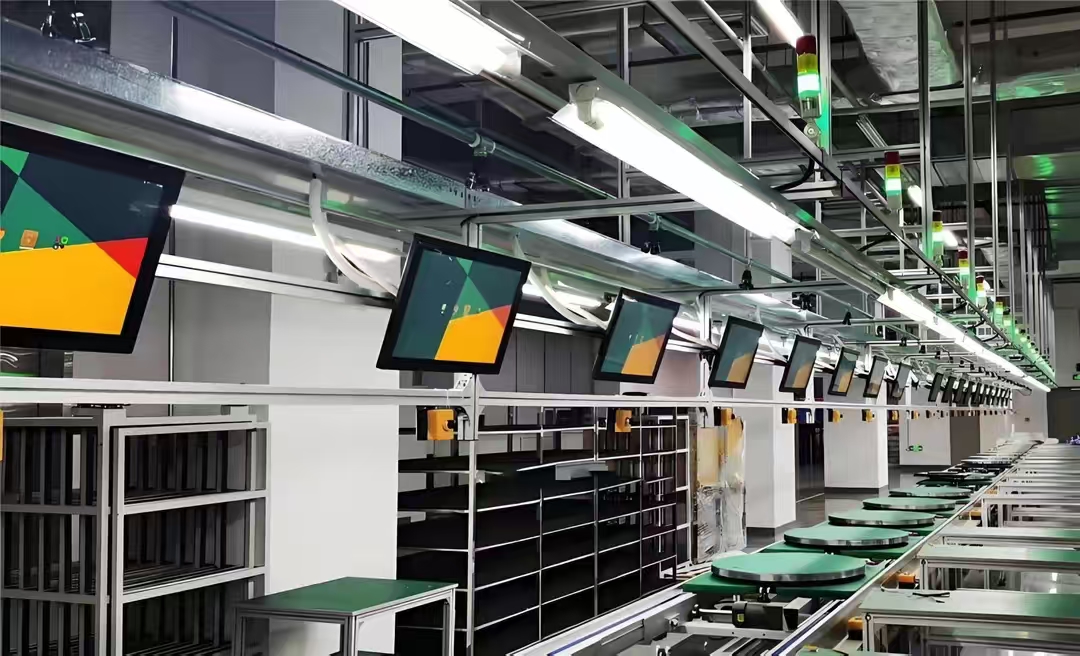
从部署形态看,工厂AI推理硬件大致分三类。第一类是数据中心级推理服务器,搭载B300、MI350或Gaudi 3,适合多路高清视频流、大模型缺陷检测和中央质检平台,优势是算力冗余大、支持多模型并发,缺点是功耗和散热要求高。第二类是边缘AI服务器,如Jetson Thor平台,算力在几百TOPS级别,适合单条产线或单台设备,支持实时控制,功耗通常在几十瓦。第三类是AI传感器加低功耗NPU方案,把推理直接放在相机或振动传感器里,只上传结果,适合布线困难或隐私敏感的场景。选型时不要只看峰值算力,要看模型在目标硬件上的实际帧率和精度保持率。科创致远在工业AI硬件方案整合方面,通常会帮客户把模型编译、散热设计和供电改造一起纳入评估,避免"卡到了、产线跑不起来"的尴尬。
四、工厂AI硬件典型应用场景
某电子厂做PCB缺陷检测,原来用云端推理,单张图往返延迟超过200毫秒,产线速度一提就漏检。换成边缘AI服务器后,推理放到车间侧,延迟压到30毫秒以内,误判率也降了。假设一家汽配企业做刹车片表面质检,用事件驱动视觉传感器加低功耗NPU,只在有变化时触发推理,功耗从原来的几百瓦降到十几瓦,还能防尘防震。再比如某化工厂做设备预测性维护,用振动和声音传感器融合推理,提前发现轴承异常,避免非计划停机。这些场景的共同点是:推理必须靠近数据源,且要和PLC、MES做实时联动。
五、选型要点与部署建议
第一,先定延迟预算。产线节拍是硬约束,推理延迟必须小于节拍的三分之一,否则再高的算力也没意义。第二,算功耗和散热。工厂电柜空间有限,风冷还是液冷、要不要改造配电,要在选型前确认。第三,看模型兼容性。训练用的框架能不能顺利编译到目标硬件,算子支持是否完整,这比纸面算力更重要。第四,考虑扩展性。今天跑一个模型,明天可能要加多路视频或大模型,服务器要留出内存和互联余量。第五,部署时先做小规模验证,用真实产线数据跑一周,确认精度和稳定性再批量复制。科创致远ESOP在工业AI硬件方案整合中,会建议客户把推理服务器、传感器和网络交换机作为一个整体做联调,而不是分开采购。目前科创致远累计服务120余家客户,覆盖15+行业,在产线侧推理部署上积累了不少工程经验。
六、技术趋势与未来展望
2026年之后,工厂AI推理硬件会朝三个方向走。一是HBM4和Chiplet让单卡推理带宽翻倍,大模型在产线侧实时跑成为常态。二是边缘NPU和AI传感器进一步融合,推理从"服务器"下沉到"传感器",事件驱动架构会替代部分连续推理。三是模块化和实时控制,Jetson Thor这类平台会让机器人和智能制造设备具备本地推理能力。对工厂来说,选型逻辑也会变:不再问"买什么卡",而是问"这条产线需要多低的延迟、多大的模型、多高的能效"。谁能把这笔账算清楚,谁就能在下一轮产线智能化里少走弯路。
 产品方案
 预约演示
 价格咨询