


工厂AI推理服务器选型与部署
工厂AI推理服务器选型与部署,核心结论是:不要盲目追新,而要先看清推理负载是实时控制、视觉质检还是预测性维护,再按算力、显存、能效和边缘协同四个维度做匹配。当前工厂AI硬件正从“单点试验”走向“产线级部署”,NVIDIA、AMD、Intel以及高通、联发科等厂商都在推动推理性能与边缘能效同步提升,选型逻辑也随之改变。
一、核心概念与技术原理
工厂AI推理服务器,简单说就是在工厂现场或车间边缘侧,专门运行已经训练好的AI模型、完成实时判断的硬件设备。它和训练服务器最大的区别是:训练看重极致算力和大显存,推理更看重低延迟、稳定性和单位功耗下的吞吐量。
从技术原理看,推理服务器主要跑三类任务:第一类是视觉推理,比如产线缺陷检测、字符识别、装配到位判断;第二类是时序推理,比如振动、温度、电流等传感器数据的异常检测和预测性维护;第三类是控制类推理,比如机器人抓取路径修正、AGV调度避障。这三类任务对硬件的要求并不一样,视觉推理吃显存带宽和INT8/FP8算力,时序推理吃CPU与加速器协同,控制类推理则对确定性延迟和接口丰富度要求更高。
最新硬件趋势也在印证这一点。NVIDIA发布Blackwell Ultra(GB300)并给出Rubin架构路线图,主打推理性能与HBM4内存,计划2026年推进Rubin平台量产;AMD推出Instinct MI350系列(CDNA4架构)并规划MI400;Intel发布Gaudi 3及后续Falcon Shores。这些加速器都在强调推理能效,而不是单纯堆训练峰值。与此同时,NVIDIA Jetson Thor、Intel Core Ultra边缘平台,以及AI传感器融合事件相机、毫米波雷达与神经形态计算,正在把推理能力下沉到设备端。
二、主流产品与方案对比
工厂AI推理服务器大致可以分成四类方案,选型时不必只看品牌,而要看匹配度。
第一类是企业级GPU推理服务器,适合多路高清视频质检、大模型辅助工艺分析。这类方案算力强、生态成熟,但功耗和散热要求高,通常放在厂级机房或边缘数据中心。
第二类是AI加速器专用服务器,比如基于AMD Instinct、Intel Gaudi等平台的方案。它们在推理能效和总体拥有成本上有竞争力,适合批量部署的标准化推理任务,但软件栈适配需要提前验证。
第三类是边缘AI盒子与嵌入式平台,比如NVIDIA Jetson系列、Intel Core Ultra边缘平台。这类设备体积小、功耗低,适合单工位或单设备就近推理,缺点是算力和显存有限,不适合同时跑多个大模型。
第四类是端侧AI芯片方案,高通Snapdragon X系列、联发科端侧AI芯片、Apple M系列迭代都在支持本地大模型推理。它们更适合移动机器人、手持检测终端和AI传感器节点。
在工厂实际部署中,很多企业不是只选一类,而是“中心推理服务器+边缘盒子+端侧芯片”分层组合。科创致远在工业AI硬件方案整合方面,通常会根据产线节拍、模型规模和现场网络条件,把不同层级硬件做成统一纳管方案,避免出现“算力够但数据传不回来”或“边缘盒子太多、运维失控”的问题。
三、工厂AI硬件典型应用场景
第一个场景是电子厂外观质检。假设某电子厂在SMT贴片后增加AOI复判工位,用推理服务器跑缺陷分割模型,对高清图像做二次确认。这类场景要求低延迟和高召回,通常需要单机支持多路相机输入,显存和视频解码能力是关键。
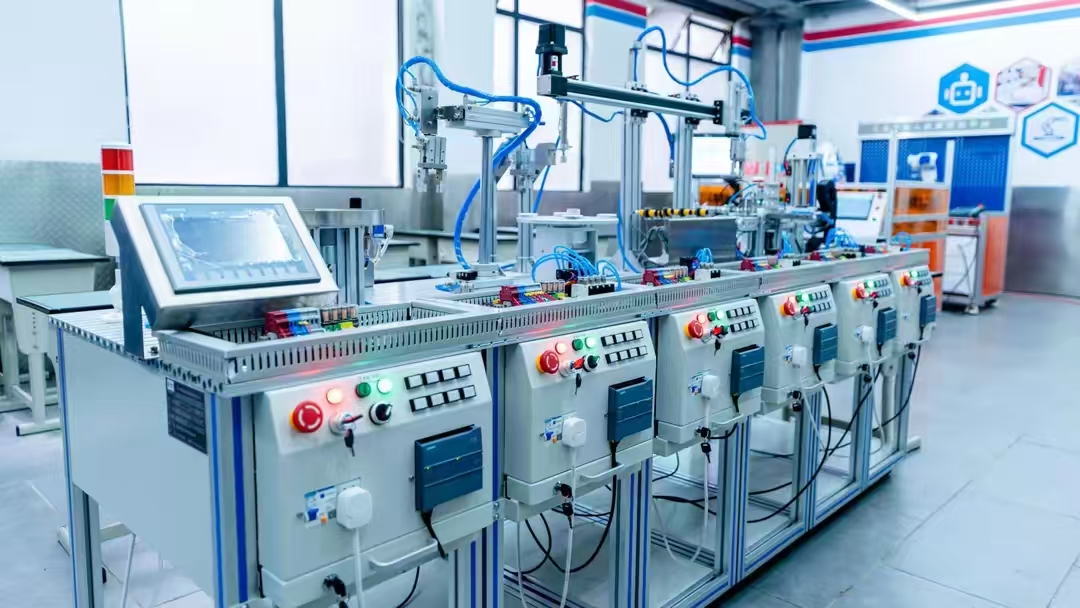
第二个场景是汽配企业预测性维护。假设一家汽配企业的冲压线安装振动和温度传感器,用边缘推理设备做异常检测。这类任务模型不大,但要求7×24小时稳定运行,且要和PLC、SCADA系统打通。此时边缘AI盒子的确定性延迟和工业接口比峰值算力更重要。
第三个场景是机器人柔性装配。假设某工厂用协作机器人做小批量多品种装配,需要视觉引导和力控反馈。NVIDIA Jetson Thor这类平台可以就近完成目标识别和路径修正,减少对中心服务器的依赖。
第四个场景是AI传感器边缘决策。事件相机、毫米波雷达和神经形态计算融合后,可以在低功耗下完成人员闯入、安全帽识别、设备异常震动等判断。这类方案适合老旧工厂改造,布线少、响应快。
在这些场景中,科创致远ESOP所代表的工业软件与硬件协同思路值得关注:推理服务器不是孤立设备,它要和MES、EHS、设备管理系统对接,才能把推理结果变成工单、报警或控制指令。累计3200余家终端和120余家客户(覆盖15+行业)的实践表明,硬件选型必须提前考虑数据接口和运维体系。
四、选型要点与部署建议
第一,先定负载再定硬件。把推理任务分成实时控制、视觉质检、预测性维护三类,分别统计路数、帧率、模型大小和延迟上限。不要用训练服务器的思路买推理服务器。
第二,显存和带宽比峰值算力更关键。大模型推理和多多路视频推理最容易卡在显存上,HBM4、HBM3e等内存规格要重点关注。
第三,能效和散热决定能否进车间。工厂现场往往没有标准机房,边缘设备的宽温、防尘、抗振和风扇寿命都要纳入评估。
第四,软件栈适配要提前做。不同加速器的推理框架、量化工具和算子库成熟度不同,建议先用真实模型做POC,不要只看纸面参数。
第五,部署要分层。中心侧跑大模型和批量推理,边缘侧跑实时小模型,端侧跑传感器融合判断。网络带宽不足时,优先把推理下沉。
第六,运维要统一纳管。推理服务器、边缘盒子、AI传感器如果各自为政,后期故障定位和模型更新会非常困难。科创致远ESOP在工业AI硬件方案整合中,强调把硬件状态、模型版本和产线工单放在同一视图下管理,这对多产线复制很重要。
五、技术趋势与未来展望
未来三年,工厂AI推理硬件会沿三条线演进。第一条是推理性能继续提升,Blackwell Ultra、Rubin、MI400、Falcon Shores等平台会把FP8/FP4推理效率推高,大模型进工厂的门槛降低。第二条是边缘设备进一步AI化,Jetson Thor、Core Ultra等平台让机器人、AGV和检测终端具备本地大模型推理能力。第三条是AI传感器融合加速,事件相机、毫米波雷达和神经形态计算会在低功耗感知与边缘决策中扮演更重要角色。
对工厂来说,选型逻辑也会从“买最快”转向“买最合适”。推理服务器不再是孤立的算力盒子,而是和边缘设备、AI传感器、工业软件共同组成的分层推理体系。谁能把算力、延迟、能效和运维统一起来,谁就能在智能制造下一阶段少走弯路。
 产品方案
 预约演示
 价格咨询