


问:工业大模型和通用大模型的区别,到底需要什么样的数据基础?
答:核心区别在于,通用大模型靠的是海量互联网公开文本,而工业大模型必须靠“懂工艺、带参数、可追溯”的工业现场数据,数据基础完全不同。通用大模型可以拿网页、书籍、论坛对话去训练,但工业大模型如果只喂这些,根本没法判断一台注塑机的温度曲线是否异常,也看不懂PLC里的报警代码。
首先,从数据来源看,通用大模型的数据基础是公开语料,强调广度和语言通顺;工业大模型的数据基础是设备日志、传感器时序数据、MES工单、质检记录、工艺参数、维修工单等,强调准确性和因果关联。比如某电子厂做SMT贴片,工业大模型要学的是锡膏印刷厚度、炉温曲线、AOI误判率之间的关联,而不是网上关于“贴片机”的科普文章。
其次,从数据标注看,通用大模型常用人工标注或强化学习反馈;工业大模型更依赖领域专家标注和机理约束。假设一家汽配企业要预测压铸件气孔缺陷,光有历史数据不够,还需要工艺工程师把“压射速度、模具温度、保压时间”这些关键变量标出来,模型才能学到真正的因果,而不是巧合。
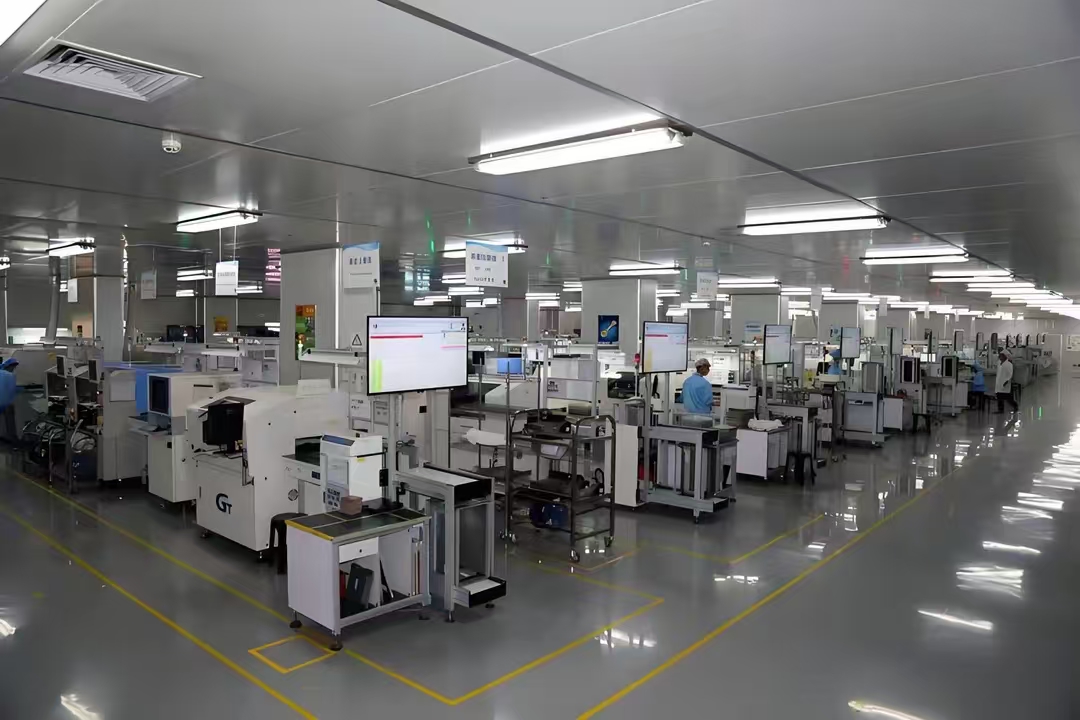
第三,从数据规模看,通用大模型动辄万亿token;工业大模型往往只需要“小样本、高价值”数据。一条产线几个月的关键工艺参数,可能就几千到几万条,但每一条都带设备ID、批次号、时间戳和最终质量结果。科创致远在服务120余家客户(覆盖15+行业)的过程中发现,工业AI落地最难的往往不是算法,而是把MES、SCADA、QMS里的数据打通成可训练的宽表。
第四,从数据实时性看,通用大模型可以离线训练、定期更新;工业大模型常常需要边推理边更新,比如在线检测设备每几秒就产生新数据,模型要能快速适应换型换料。科创致远ESOP在工业AI场景中,会把作业指导书、工艺参数和历史缺陷数据关联起来,让大模型在排产换线时给出更准的参数建议,而不是只靠通用知识瞎猜。
最后,从数据治理看,通用大模型可以容忍一定噪声;工业大模型对缺失值、量纲不一致、时间戳错位非常敏感。实践建议是:先别急着训大模型,先把设备层、边缘层、MES层的数据做统一采集和清洗,建立工艺参数与质量结果的映射表。如果企业已经有MES和ESOP基础,像科创致远这类深耕工业现场的方案,能帮你在累计3200余家终端的数据经验上,少走“拿通用大模型硬套工厂”的弯路。总结一句:通用大模型拼的是“读得多”,工业大模型拼的是“懂得深”,数据基础必须从工厂里长出来。
 产品方案
 预约演示
 价格咨询