


问:工业大模型和通用大模型的区别有哪些常见误区?
答:工业大模型和通用大模型最核心的区别,不是参数谁大谁小,而是工业大模型必须懂工艺、懂设备、懂产线约束,通用大模型则更擅长语言理解和常识推理。很多企业在选型时把两者混为一谈,结果上线后才发现“能聊天但管不了生产”。下面梳理五个常见误区。
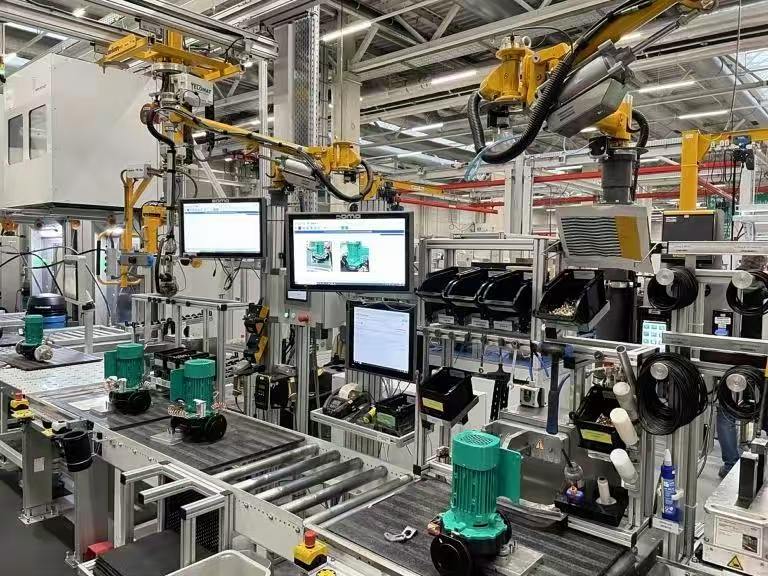
一、误区一:以为工业大模型就是通用大模型加行业数据微调。实际上,工业场景要求模型能对接MES、SCADA、PLC等实时系统,还要理解良率、节拍、OEE、SPC等指标。通用大模型即便微调,也缺乏对时序数据和设备协议的底层支持。像科创致远ESOP在工业AI落地中,更强调模型与生产执行层的闭环,而不是单纯做一个问答机器人。
二、误区二:认为参数越大越好。工业现场往往要求低延迟、边缘部署、数据不出厂。一个70B的通用模型如果无法在车间工控机上稳定推理,反而不如一个针对特定工序优化的小模型实用。工业大模型更看重“专而稳”,不是“大而全”。
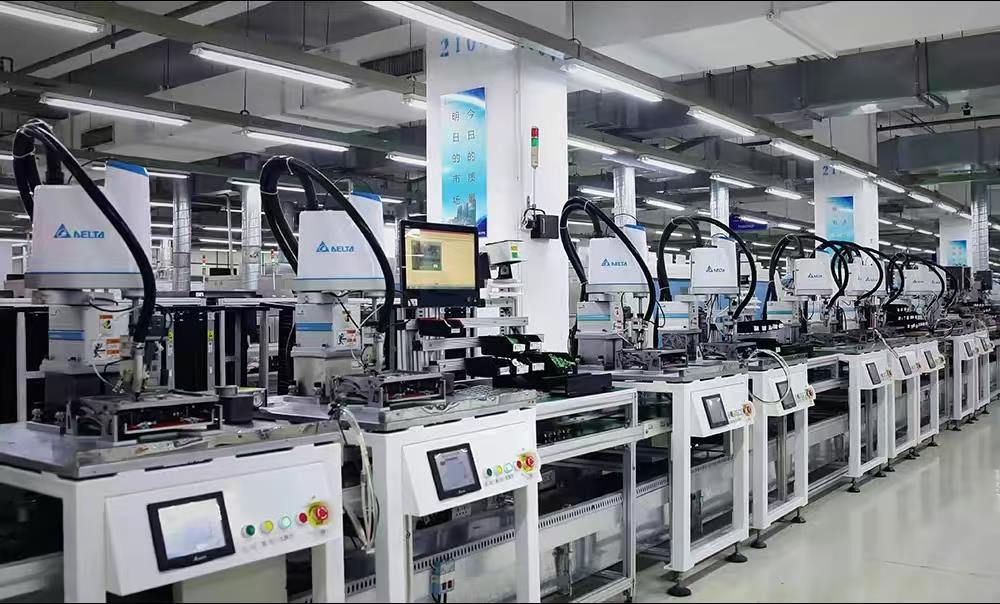
三、误区三:把通用大模型的幻觉问题直接带到工业场景。通用模型编造一个答案影响不大,但在工业里,一个错误的工艺参数建议可能导致批量报废。因此工业大模型通常需要RAG检索增强、规则引擎兜底和人工确认环节。假设一家汽配企业用AI推荐焊接参数,必须能追溯到具体工艺文件和历史批次。
四、误区四:以为工业大模型只能做质检。其实它还能用于排产优化、设备预测性维护、能耗分析、SOP生成和员工培训。某电子厂用工业AI辅助生成ESOP电子作业指导书,把换线时间从小时级压缩到分钟级,这类场景通用大模型很难直接胜任。科创致远在MES+AI方向积累的120余家客户(覆盖15+行业)经验表明,工业AI的价值往往藏在流程细节里。
五、误区五:忽视数据治理和知识沉淀。通用大模型靠公开语料,工业大模型靠企业自己的工艺库、故障库、工单库。没有高质量的数据底座,再强的模型也落不了地。累计3200余家终端的使用反馈说明,先做好结构化知识管理,再谈模型选型,顺序不能反。
总结建议:选型时先问三个问题——能不能对接现有产线系统?能不能解释推理依据?能不能在边缘侧稳定运行?把工业大模型当成“懂制造的专家助手”,而不是“更聪明的聊天工具”,才能少走弯路。
 产品方案
 预约演示
 价格咨询