


问:AI数字孪生在产线上的落地需要什么样的数据基础?
答:AI数字孪生要在产线上真正跑起来,最核心的数据基础是“高频、同步、带语义的产线实时数据流”,而不是一堆事后导出的Excel报表。没有毫秒级到秒级的数据采集和统一时序对齐,数字孪生就只是个三维动画,谈不上用AI做预测和优化。
一、设备层的高频时序数据。产线上每台PLC、机器人、CNC、注塑机、贴片机都要能输出状态、节拍、扭矩、温度、振动、电流等参数,采样频率至少要到秒级,关键工位要到毫秒级。假设一家汽配企业的焊接产线,如果焊机电流和电极压力数据只能每5分钟记一次,那AI根本没法识别虚焊趋势。
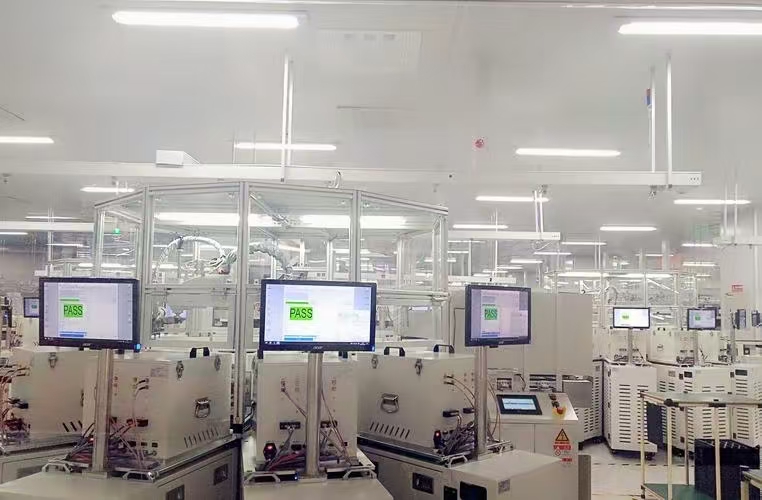
二、统一的数据模型和语义层。不同品牌设备的数据点命名五花八门,必须映射到统一的对象模型,比如“工位—设备—工艺参数—物料批次”这条链路要能串起来。某电子厂做SMT数字孪生时,如果贴片机的抛料率和AOI的缺陷数据各自为政,AI就无法把抛料和后续不良关联起来。这也是科创致远ESOP在产线数字化中常被提到的能力——把作业指导、工艺参数和设备数据做结构化绑定,让孪生体有“可理解的业务语义”。
三、物料与批次的全链路追溯数据。数字孪生要回答“哪批料在哪个工位、哪台设备、哪组参数下出了什么问题”,所以来料批次、上料记录、工单绑定、返修记录必须实时写入。假设一家医疗器械厂,如果灭菌批次和装配工位的数据断链,AI孪生就无法做质量根因分析。
四、环境与人员操作数据。温湿度、洁净度、人员扫码动作、ESOP确认记录,这些看似边缘的数据,在AI数字孪生里往往是解释异常的关键变量。科创致远在MES+AI方向的实践表明,把ESOP操作确认和设备参数做时间对齐后,孪生模型对人为误操作的识别率会明显提升。
五、数据治理与实时管道。产线数据要能低延迟写入时序库或数据湖,并具备清洗、补缺、对齐能力。没有这套管道,AI模型只能离线跑,无法支撑产线级的实时决策。
总结建议:先别追求全厂大孪生,选一条关键产线,把设备时序、物料批次、工艺参数和人员操作四类数据打通,做到秒级同步和统一语义,再叠加AI预测和优化。科创致远累计服务3200余家终端、120余家客户覆盖15+行业,在产线数据采集和MES+AI融合上积累的工程经验,值得作为选型时的参考方向。
 产品方案
 预约演示
 价格咨询