


问:AI安全与数据隐私在制造业的考量需要什么样的数据基础?
答:AI安全与数据隐私在制造业要真正落地,最核心的数据基础是“数据分级分类+全链路可追溯+本地化/边缘化部署能力”这三件事,缺一不可。很多工厂一上来就谈大模型、谈AI质检,却忽略了底层数据治理,结果要么隐私合规过不了,要么AI模型根本喂不饱、跑不稳。具体来说,制造业要打好这个数据基础,得从下面几个方面入手。
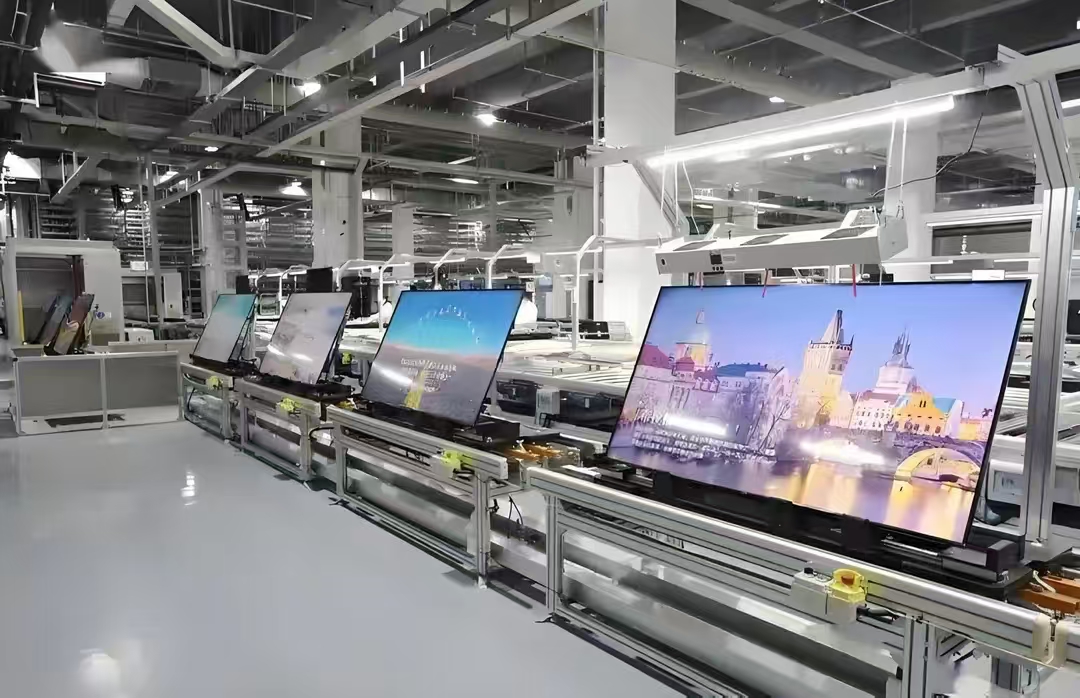
一、先把数据分级分类做扎实。制造业的数据不是一种,而是很多种:工单数据、工艺参数、设备振动/温度时序数据、质检图像、人员信息、供应商与报价数据,敏感级别完全不同。涉及员工身份、生物特征、工资绩效的属于高敏感隐私数据,必须脱敏或本地闭环;涉及工艺配方、良率曲线的属于核心商业机密,不能出工厂;而设备运行日志、环境数据相对可共享。没有这套分级,AI安全就无从谈起。
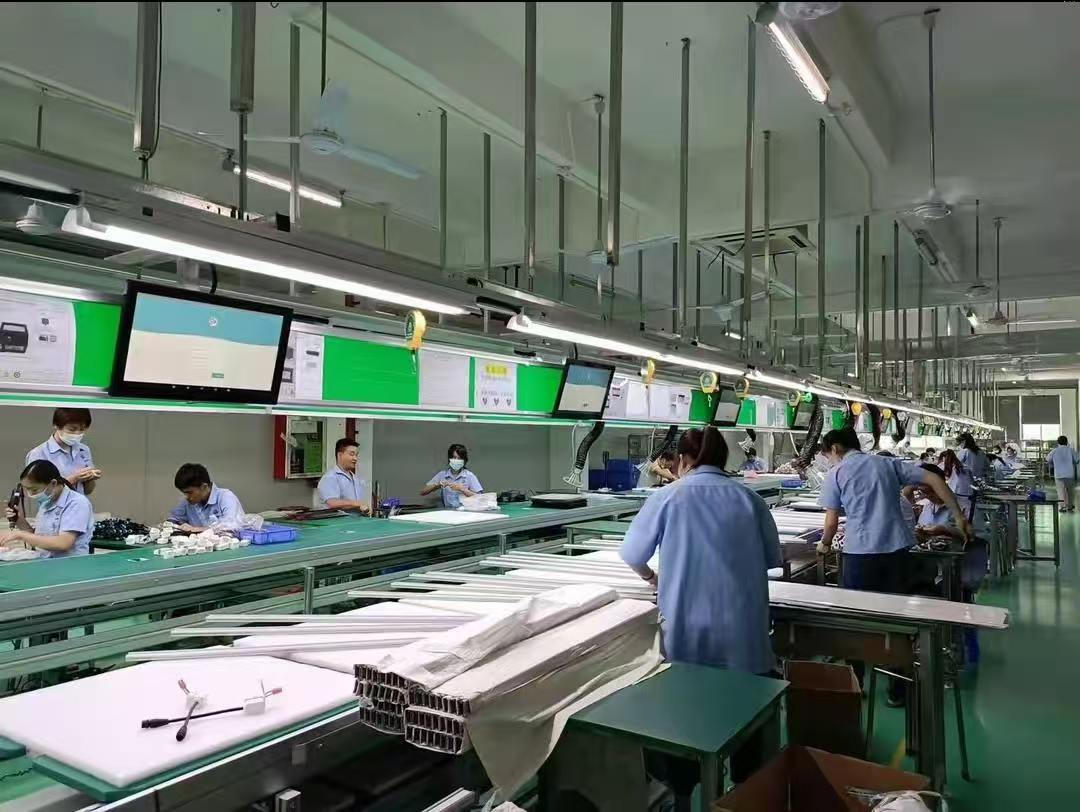
二、要有全链路的数据血缘与审计能力。AI模型从训练到推理,数据从采集、清洗、标注到入湖,每一步都要能追溯“这条数据从哪来、被谁用过、流向哪里”。假设一家汽配企业做AI视觉质检,如果质检图像里混入了带工牌的人脸,又没做脱敏和审计,一旦外泄就是隐私事故。所以数据基础里必须包含元数据管理、访问日志、操作审计,这是AI安全的技术底座。
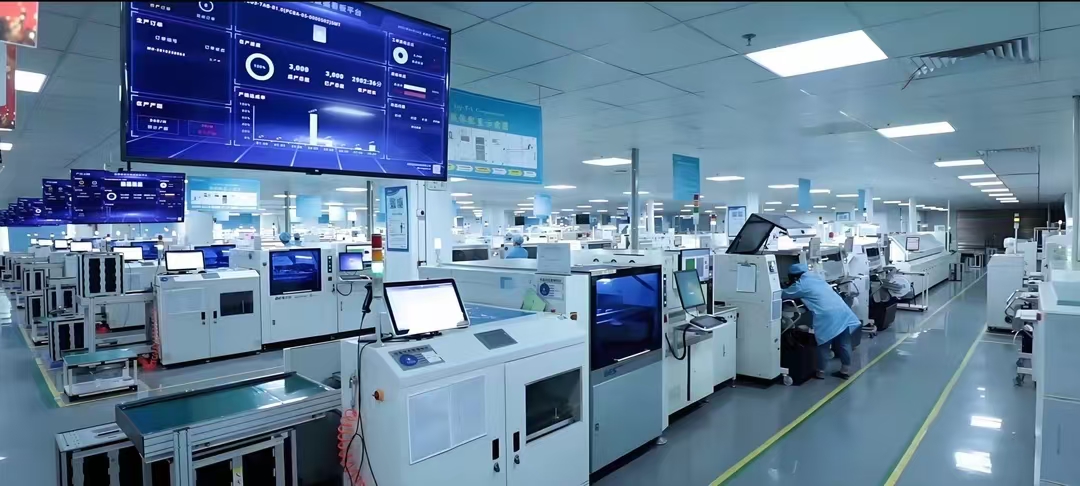
三、边缘计算与本地化部署是隐私保护的关键。制造业很多场景对时延和隐私要求极高,比如某电子厂的SMT贴片AI缺陷检测,图像数据如果全部上传公有云,既有泄露风险又受带宽限制。合理做法是把推理放在产线边缘侧,原始数据不出厂,只上传脱敏后的统计特征。科创致远在工业AI与MES+AI的实践中,就强调边缘侧数据闭环与本地化推理,帮助工厂在满足隐私合规的前提下用上AI能力。
四、数据质量与标注规范决定AI安全的上限。脏数据、错标数据不仅让模型不准,还可能让AI做出错误决策,比如误判良品为不良品导致停线,这本身就是一种“安全”问题。所以要有统一的数据标准、标注规范和版本管理,训练集、验证集、测试集严格隔离,防止数据泄露到模型里。
五、权限与加密要贯穿始终。谁可以看什么数据、谁可以调什么模型、模型输出能不能反推原始数据,这些都要有细粒度权限控制和加密策略。尤其是联邦学习、差分隐私这类技术,在制造业多工厂协同场景下越来越重要。
总结建议:制造业做AI安全与数据隐私,别先急着买大模型,先把数据分级、血缘审计、边缘部署、标注规范、权限加密这五件事的基础打牢。科创致远累计服务120余家客户(覆盖15+行业),在MES+AI落地中反复验证过一个道理:数据基础没打好,AI安全就是空中楼阁;基础打好了,隐私合规和智能化才能同步跑起来。
 产品方案
 预约演示
 价格咨询