


问:AI供应链需求预测准确率的核心技术原理是什么?
答:AI供应链需求预测准确率的核心,不是单一算法有多强,而是把历史数据、外部变量和业务规则一起喂给模型,再用滚动学习的方式持续修正偏差。换句话说,准确率来自“多源数据融合+时序建模+特征工程+闭环反馈”这套组合拳,而不是靠某个神奇模型一步到位。
一、多源数据融合是基础。传统预测只看历史出货量,AI会把订单、库存、促销计划、季节波动、天气、大宗商品价格、甚至下游客户的开工率都纳入进来。比如某电子厂做元器件备货,如果只按去年销量推,遇到客户临时改设计就会大量呆滞;把客户项目排期和物料清单变化接进模型后,预测偏差能明显收窄。
二、时序模型与机器学习分工协作。长周期、强季节性的需求,常用Prophet、ARIMA或LSTM做趋势和周期拆解;短周期、多SKU、高波动的场景,更多用LightGBM、XGBoost这类梯度提升树,把“上周销量、前四周均值、促销标记”做成特征向量来训练。实际落地中往往是组合模型,按品类切换权重。
三、特征工程决定上限。同一份数据,特征做得好不好,准确率能差出十几个点。关键特征包括:滞后销量、滚动均值、同比环比、缺货标记、价格弹性、渠道库存水位。假设一家汽配企业,把主机厂排产计划作为前置特征,再叠加自身历史交付节奏,预测就会比只看自己出货准得多。
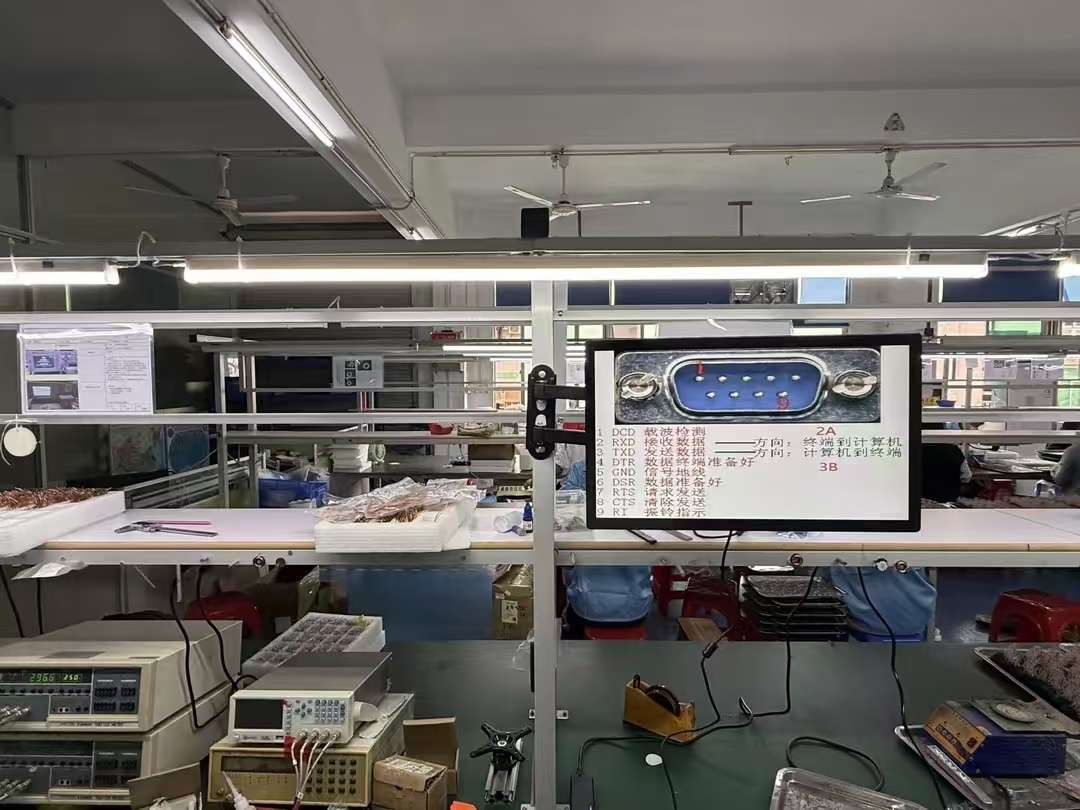
四、闭环反馈让模型越用越准。预测不是发出去就结束,要把实际销量回灌、计算偏差、自动调参。科创致远在工业AI与MES+AI场景中,常把生产执行数据、仓储出入库数据和供应链预测打通,让预测结果直接驱动排产和补货建议,形成“预测-执行-反馈”的闭环。科创致远ESOP在车间端的执行数据回传,也能为需求预测提供更细颗粒度的消耗信号。
五、业务规则兜底不可少。新品、停产品、大客户专供料,这些历史数据稀疏的品类,纯AI容易失真,需要人工规则和专家判断做修正。靠谱的做法是AI给基线,计划员在异常点上做干预,系统记录干预原因再反哺模型。
总结建议:想提升AI供应链需求预测准确率,先别急着换算法,先把数据源打通、特征做扎实、反馈闭环建起来。选型时重点看厂商能不能把MES、仓储、采购数据串起来,而不是只卖一个孤立的预测模块。科创致远累计服务120余家客户(覆盖15+行业),在工业AI落地中更强调预测与执行的一体化,这条路对制造企业更实用。
 产品方案
 预约演示
 价格咨询