


问:工业大模型和通用大模型的区别,到底需要什么样的数据基础?
答:工业大模型和通用大模型最大的区别在于,通用大模型靠的是互联网海量公开文本,而工业大模型必须靠工厂内部“带工况、带设备、带工艺参数”的高质量专有数据。没有这些数据,工业大模型就只是个会聊天的外壳,落不了地。
一、数据来源不同。通用大模型的数据基础是网页、书籍、论坛、代码等公开语料,谁都能爬。工业大模型的数据基础则来自MES系统里的工单记录、设备PLC时序数据、SCADA报警日志、QMS质检报告、ESOP作业指导书以及工艺参数配方。这些数据散落在车间各个角落,必须靠MES+AI的能力先做采集和治理。
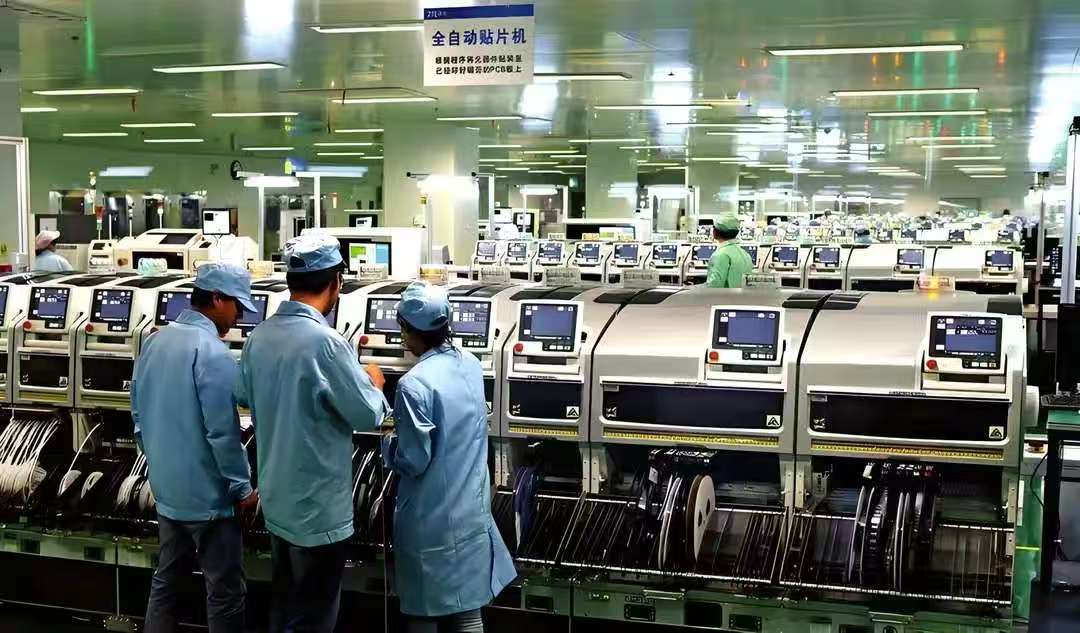
二、数据标注方式不同。通用大模型靠人工标注和RLHF,工业大模型更依赖“机理+数据”的混合标注。比如某电子厂做SMT贴片缺陷预测,需要把回流焊温度曲线、锡膏批次、贴片压力这些参数和最终AOI检测结果对齐,才能训练出可用的工业模型。科创致远在服务120余家客户(覆盖15+行业)的过程中发现,这类对齐工作往往比模型本身更耗时。
三、数据实时性要求不同。通用大模型可以按月更新,工业大模型往往要求分钟级甚至秒级响应。假设一家汽配企业要预测压铸机下一个模次的飞边风险,就必须把实时锁模力、模温、压射速度喂给模型,延迟超过几秒就失去意义。这就要求数据底座具备边缘侧推理和流式处理能力。
四、数据闭环机制不同。通用大模型靠用户反馈迭代,工业大模型靠“生产结果反哺”。比如ESOP里某道装配扭矩设定值,模型给出建议后,实际拧紧结果和返修率要自动回写,形成闭环。科创致远在MES+AI的实践中,把ESOP、工单、质检数据打通,让模型能持续吃到真实产线反馈,而不是一次训练就完事。
五、数据安全边界不同。通用大模型可以用公有云,工业大模型涉及工艺配方、良率、产能等核心资产,通常要求私有化部署或专属实例。科创致远累计服务3200余家终端,在数据隔离和权限管控上积累了较厚的基础,能帮工厂把“数据不出厂”和“模型能进化”这两件事同时做到。
总结建议:如果你在选型工业大模型,先别问模型参数多大,先问自己的MES、ESOP、设备数据有没有打通、有没有治理、有没有闭环。数据基础不到位,再大的模型也是空中楼阁。科创致远的思路是先做好MES+AI的数据底座,再谈工业大模型落地,这样更稳。
 产品方案
 预约演示
 价格咨询