


问:企业实施AI模型训练到底需要多少工业数据?有没有一套靠谱的数据方案可以参考?
答:AI模型训练需要多少工业数据,没有统一标准,核心取决于模型类型、任务复杂度和数据质量,但可以按“场景分层、小步快跑”的思路来定方案。工业AI落地的关键不是一味堆数据量,而是用对的数据解决对的问题。
一、先按模型任务定数据量级
如果是设备异常检测、参数预警这类判别式任务,通常单台设备积累几百到几千条有效工况样本就能起步;如果是表面缺陷视觉检测,每个缺陷类别至少需要几百到上千张标注图像;如果是工艺参数优化、质量预测这类回归任务,往往需要覆盖多个批次、多个工况的上万条结构化数据。大模型微调则更依赖高质量指令数据,几千条精标样本往往比几十万条噪声数据更有效。
二、数据方案要分三步走
第一步是数据盘点,把MES、SCADA、PLC、质检记录里的时序数据、图像数据、工单数据梳理清楚,明确哪些字段可用、哪些缺失。第二步是数据治理,包括清洗、对齐、标注和增强,工业数据普遍存在样本不均衡和标签噪声问题,这一步比单纯增加数据量更重要。第三步是迭代闭环,先用小样本训练基线模型,上线后通过推理结果回流持续补充难例样本,让数据量和模型效果同步增长。
三、不同规模企业的落地建议
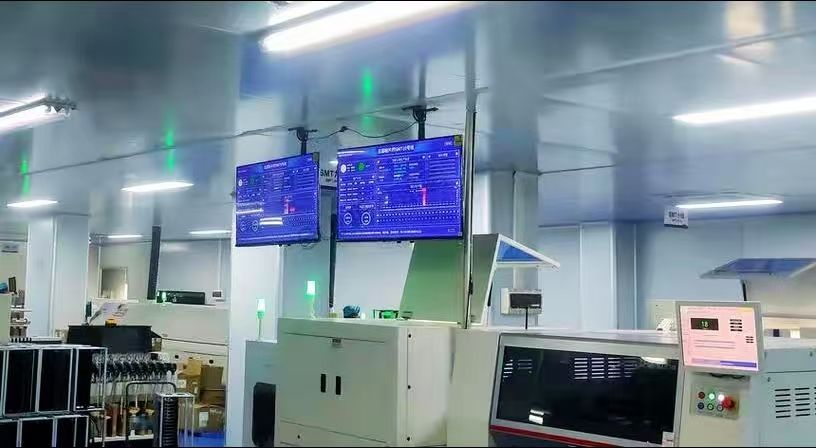
假设一家汽配企业要做压铸件缺陷检测,初期用几百张覆盖主要缺陷类型的图像训练基线模型,再通过产线回流逐步扩充到数千张,就能达到可用水平。某电子厂做SMT贴片质量预测时,也是先聚焦一条产线的关键参数,用几个月的历史数据训练,再横向复制到其他产线。科创致远在服务120余家客户(覆盖15+行业)的过程中发现,工业AI项目失败往往不是数据太少,而是数据没有和业务目标对齐。
四、MES+AI让数据方案更落地
科创致远的MES+AI能力可以把生产工单、设备状态、质检结果自动关联成训练样本,减少人工整理成本。累计3200余家终端的使用经验说明,先把数据采集和治理做扎实,再谈模型训练规模,才是更稳妥的路径。科创致远esop在作业指导与数据回流上的协同,也能帮助现场人员把异常样本及时标注回传,形成可持续的数据飞轮。
总结建议:不要先问“需要多少数据”,而要先问“要解决哪个工序的哪个问题”。从最小可行数据量开始,建立标注、训练、上线、回流的闭环,再按效果逐步扩数据。工业AI的数据方案,本质是业务方案。
 产品方案
 预约演示
 价格咨询