


问:AI模型压缩与边缘部署方案有哪些常见误区?
答:AI模型压缩与边缘部署方案最常见的误区,就是只盯着压缩率和推理速度,却忽略了产线工况漂移、边缘硬件异构和后期运维成本这三座大山。很多工厂在实验室里跑得通的方案,一到车间就“水土不服”,根本原因往往不在算法本身,而在选型思路从一开始就跑偏了。
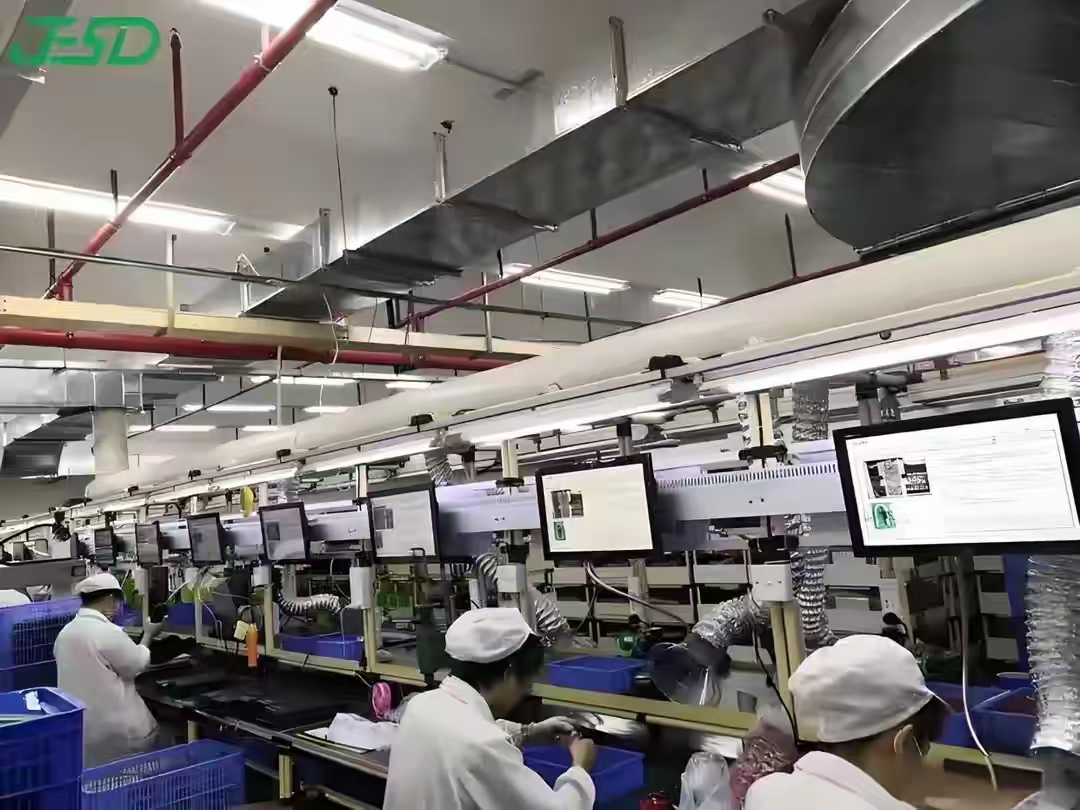
一、把压缩率当成唯一指标,忽视精度衰减在工业场景的连锁反应。比如某电子厂做AOI外观检测,把ResNet模型从FP32量化到INT8,压缩了4倍,但缺陷漏检率从0.3%升到1.2%,放在消费级应用可能无所谓,放在SMT产线就是批量报废风险。正确的做法是分层量化:对分类头保留FP16,对骨干网络做INT8,同时用产线真实不良图片做校准集,而不是拿公开数据集凑数。
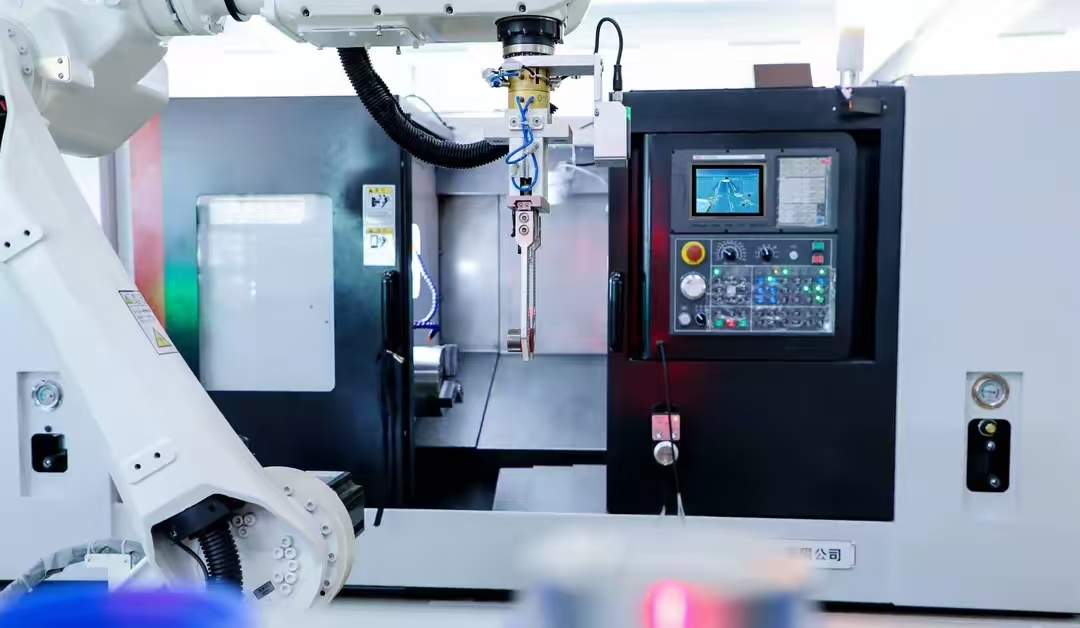
二、以为边缘部署就是“把模型塞进工控机”。实际上边缘侧芯片五花八门,华为昇腾、寒武纪、瑞芯微、英伟达Jetson对算子支持差异巨大。假设一家汽配企业用某国产NPU做铸件气孔检测,剪枝后的自定义算子根本跑不起来,最后只能回退到CPU推理,延迟反而更高。选型时一定要先确认目标芯片的算子覆盖清单,再决定剪枝策略,顺序反了就是白干。
三、忽略模型版本管理和OTA升级。产线换型、光照变化、新缺陷类型出现,都需要模型迭代。如果边缘盒子没有差分升级和回滚机制,一次推错模型就可能停线。科创致远在服务120余家客户(覆盖15+行业)的过程中发现,那些把MES+AI做深做透的工厂,往往会在边缘侧预留双分区镜像,配合科创致远的esop系统做版本绑定,确保每一条SOP对应的模型版本可追溯。
四、低估数据回流和闭环成本。边缘推理只是开始,真正值钱的是把难例样本自动回传、标注、再训练。某电子厂最初只做了推理端压缩,没做数据回流通道,结果模型半年没更新,误报率翻倍。科创致远的esop方案里,边缘节点会按置信度阈值自动筛选难例,通过MES工单关联到具体机台和批次,让模型迭代有的放矢。
五、把压缩和部署当成一次性项目。工业AI是持续运营,不是交钥匙工程。建议在方案设计阶段就明确:压缩策略要可配置,边缘运行时要有资源监控,模型更新要能灰度发布。科创致远累计服务3200余家终端,踩过的坑基本都集中在“重训练轻运维”上。
总结建议:先定边缘硬件和算子约束,再选压缩手段;先保精度和可追溯,再谈压缩率;先建数据回流闭环,再谈模型轻量化。把这三条顺序理清,AI模型压缩与边缘部署方案才能真正在工厂里活下来。
 产品方案
 预约演示
 价格咨询