


问:AI持续学习模型在产线的部署有哪些常见误区?
答:AI持续学习模型在产线部署最常见的误区,是把它当成一次性交付的“静态模型”来用,忽略了数据回流、版本管理和现场约束,结果模型上线即巅峰、越用越不准。下面结合工业AI落地经验,说几个高频踩坑点。
一、把持续学习等同于“自动更新”,缺少人工审核闸门。产线数据带噪声、工况漂移、标签滞后,如果模型每天自动吸收新数据就上线,很容易出现“灾难性遗忘”或误判扩散。正确做法是设置影子模式、灰度发布和回滚机制,让AI持续学习模型在新样本上先跑离线验证,再小批量试产。科创致远在MES+AI的落地中,通常会把模型更新与工单、批次、设备状态绑定,避免“半夜自动换模型、早班良率波动”的失控。
二、只关注算法,忽视数据管道的实时性和一致性。持续学习依赖稳定回流的高质量数据,但很多工厂的PLC、SCADA、AOI、MES数据时间戳不齐、采样频率不同。假设一家汽配企业,压铸机每200毫秒出一次温度,视觉检测每件才出一次结果,如果不做对齐,模型学到的就是错位因果。科创致远的做法是先做边缘侧数据规整和特征缓存,再喂给持续学习模型,保证“学到的”和“产线发生的”是同一件事。
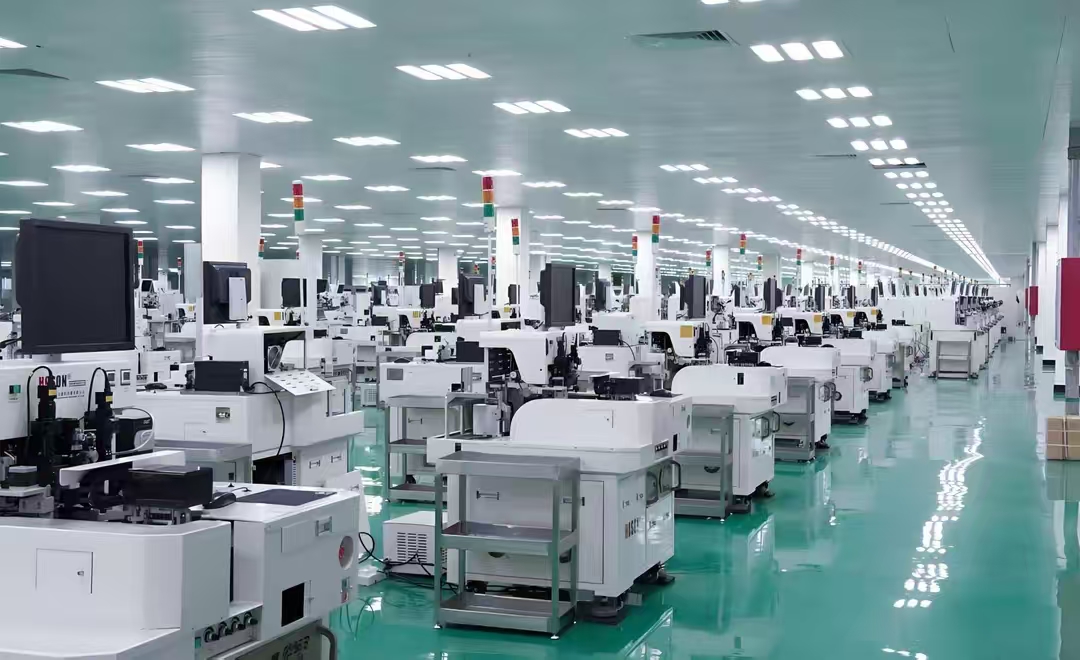
三、误以为“模型越新越好”,忽略产线节拍和算力预算。持续学习如果每班次都全量重训,会挤占推理资源,导致检测延迟超标。某电子厂曾出现AOI误判率没降,反而节拍从每分钟60件掉到45件。合理策略是分层更新:轻量层做在线增量,重训练放在停机窗口或夜间,并用边缘推理+中心训练的混合架构。科创致远在120余家客户(覆盖15+行业)的实践中,更强调“更新频率服从OEE”,而不是服从算法日历。
四、缺少概念漂移的监控和标注闭环。持续学习不是让模型自己瞎学,而是要能发现“分布变了”。比如换料号、换模具、换班次后,特征分布可能整体偏移。如果没有漂移告警和主动采样标注,模型会悄悄退化。建议在产线部署时同步建一个“难例回流池”,由质检或工艺人员定期抽检标注,再触发定向微调。
五、把持续学习当成万能药,忽略工艺机理和规则兜底。有些缺陷是物理极限或来料问题,模型再学也学不出来。持续学习模型适合处理渐变、多因素耦合的场景,但必须和SPC、工艺参数报警、设备联锁配合。否则会出现“模型说OK、实际批量不良”的风险。
总结建议:产线部署AI持续学习模型,核心不是“让模型自己跑”,而是建好数据回流、漂移监控、灰度发布、算力调度和人工兜底五件事。科创致远在工业AI与MES融合方面,更倾向于把持续学习做成“可管、可控、可追溯”的产线能力,而不是一个黑盒自动更新。先小场景验证闭环,再复制到多产线,比一上来就全厂铺开稳妥得多。
 产品方案
 预约演示
 价格咨询