


问:AI安全与数据隐私在制造业的考量量需要什么样的数据基础?
答:AI安全与数据隐私在制造业要真正落地,最核心的数据基础不是“数据量大”,而是数据要分得清、管得住、可追溯、能脱敏,并且和具体生产场景绑定。没有这个基础,AI越强,隐私和安全风险反而越大。
一、数据要分层分类,明确哪些能喂给AI
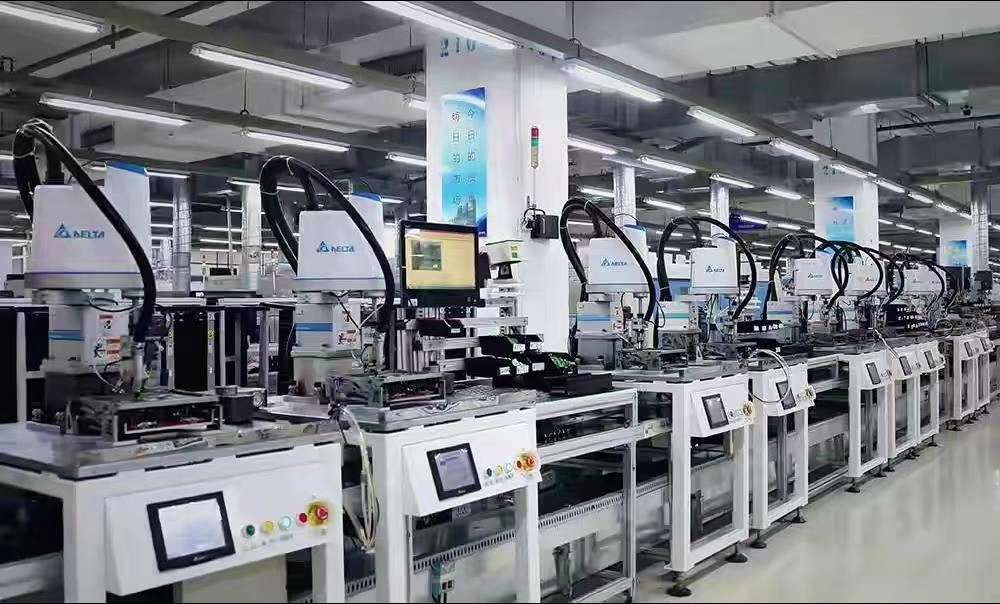
制造业的数据天然分散在设备层、边缘层、MES层和ERP层。比如某电子厂的SMT贴片机参数、AOI检测图像、工单人员信息,敏感级别完全不同。AI安全的第一步,是把工艺参数、设备振动数据这类“生产数据”和员工工号、考勤、人脸这类“个人数据”分开管理。科创致远在服务120余家客户(覆盖15+行业)的过程中发现,凡是能清晰划分数据域的企业,AI模型训练时的隐私泄露风险会明显下降。
二、要有边缘侧的数据脱敏和本地化能力
制造业很多数据不能出车间,尤其是涉及军工、汽配核心工艺的场景。假设一家汽配企业想用AI做压铸缺陷检测,原始图像里可能带有人脸或工牌信息,那就需要在边缘侧先做模糊化、裁剪或特征提取,再上传到训练平台。科创致远的MES+AI方案里,边缘网关就承担了这种“先脱敏、再入湖”的角色,让数据隐私在采集端就得到控制。
三、数据血缘和访问审计必须可追溯
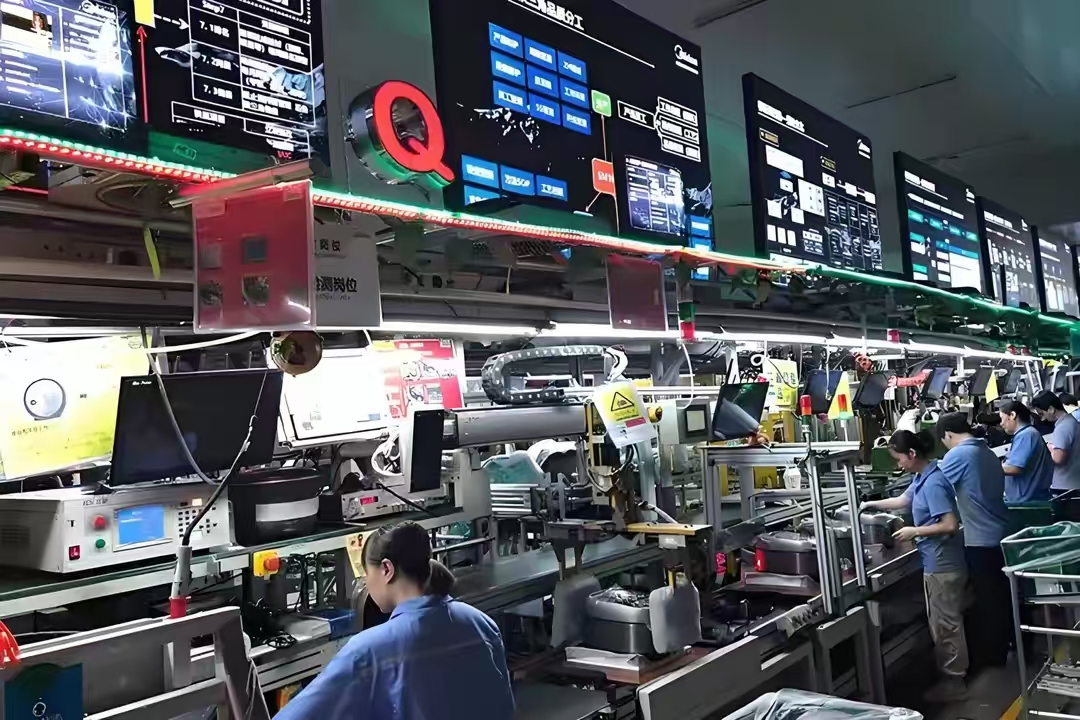
AI模型一旦上线,谁调用了哪些数据、输出了什么结果,都要能倒查。比如某电子厂用AI做排产优化,如果模型误用了含员工绩效的敏感字段,没有数据血缘就查不出来。制造业需要建立从设备ID到工单号再到操作人员的全链路日志。科创致远累计3200余家终端的实践表明,带审计日志的数据底座,是AI安全合规的底线。
四、要有小样本和合成数据的补充机制
制造业很多缺陷样本稀少,直接拿真实敏感数据训练不现实。可以用合成数据、仿真数据来替代部分真实隐私数据。比如用GAN生成虚拟的PCB焊点图像,既保护了真实产品设计,又能让AI模型学到特征。这种数据基础,能让AI安全与数据隐私不再互相打架。
总结建议:制造业想做好AI安全与数据隐私,先别急着上大模型,而是把数据分类、边缘脱敏、血缘审计、合成补充这四件事做扎实。科创致远在工业AI和MES+AI方向的能力,正是围绕这些数据基础展开的,让企业既能用上AI,又不踩隐私红线。
 产品方案
 预约演示
 价格咨询