


AIAgent的记忆机制设计
AI Agent的记忆机制设计,决定了它到底是“一次性问答工具”还是“越用越懂业务的数字员工”。在智能制造场景里,没有记忆的Agent只能做单点问答,而具备分层记忆的Agent才能跨班次、跨工单、跨设备地积累经验,真正融入生产流程。这也是近两年工业AI从“大模型接入”走向“Agent落地”时,被讨论最多的技术分水岭。
一、核心概念与定义
AI Agent的记忆机制,是指智能体在运行过程中对信息进行编码、存储、检索和遗忘的一整套设计。它不同于大模型本身的参数记忆,而是外挂式的、可读写的上下文管理系统。通常分为三类:短期记忆,对应单次会话或单个工单的上下文窗口;长期记忆,对应跨会话持久化的向量数据库或知识图谱;程序性记忆,对应固化下来的操作流程、规则和工具调用模板。
在工业场景中,记忆机制还要多一层“工况记忆”——比如某台贴片机在换料后的前30分钟容易抛料,这种与设备状态、时间、批次强绑定的经验,必须被结构化存储,才能被下一次排产或点检调用。科创致远在服务120余家客户(覆盖15+行业)的过程中发现,制造企业真正需要的不是“能聊天的AI”,而是“记得住工艺参数、记得住设备脾气”的Agent。
二、技术原理与关键能力
记忆机制的核心能力可以拆成四步:写入、索引、召回、遗忘。
写入环节,Agent要把对话、传感器读数、MES工单、维修记录等多源信息转成统一表示。常见做法是用嵌入模型转成向量,同时保留元数据,比如时间戳、设备编号、产线号。
索引环节,要解决“怎么找得到”。纯向量检索容易在工业术语上失准,比如“飞达”和“供料器”是同一件事,但向量距离可能很远。所以成熟方案会做混合索引:向量加关键词加知识图谱关系。科创致远在MES+AI的实践中,把工艺BOM、设备台账、历史报警记录做成图谱节点,Agent召回时先走图谱关系,再走向量相似度,准确率明显提升。
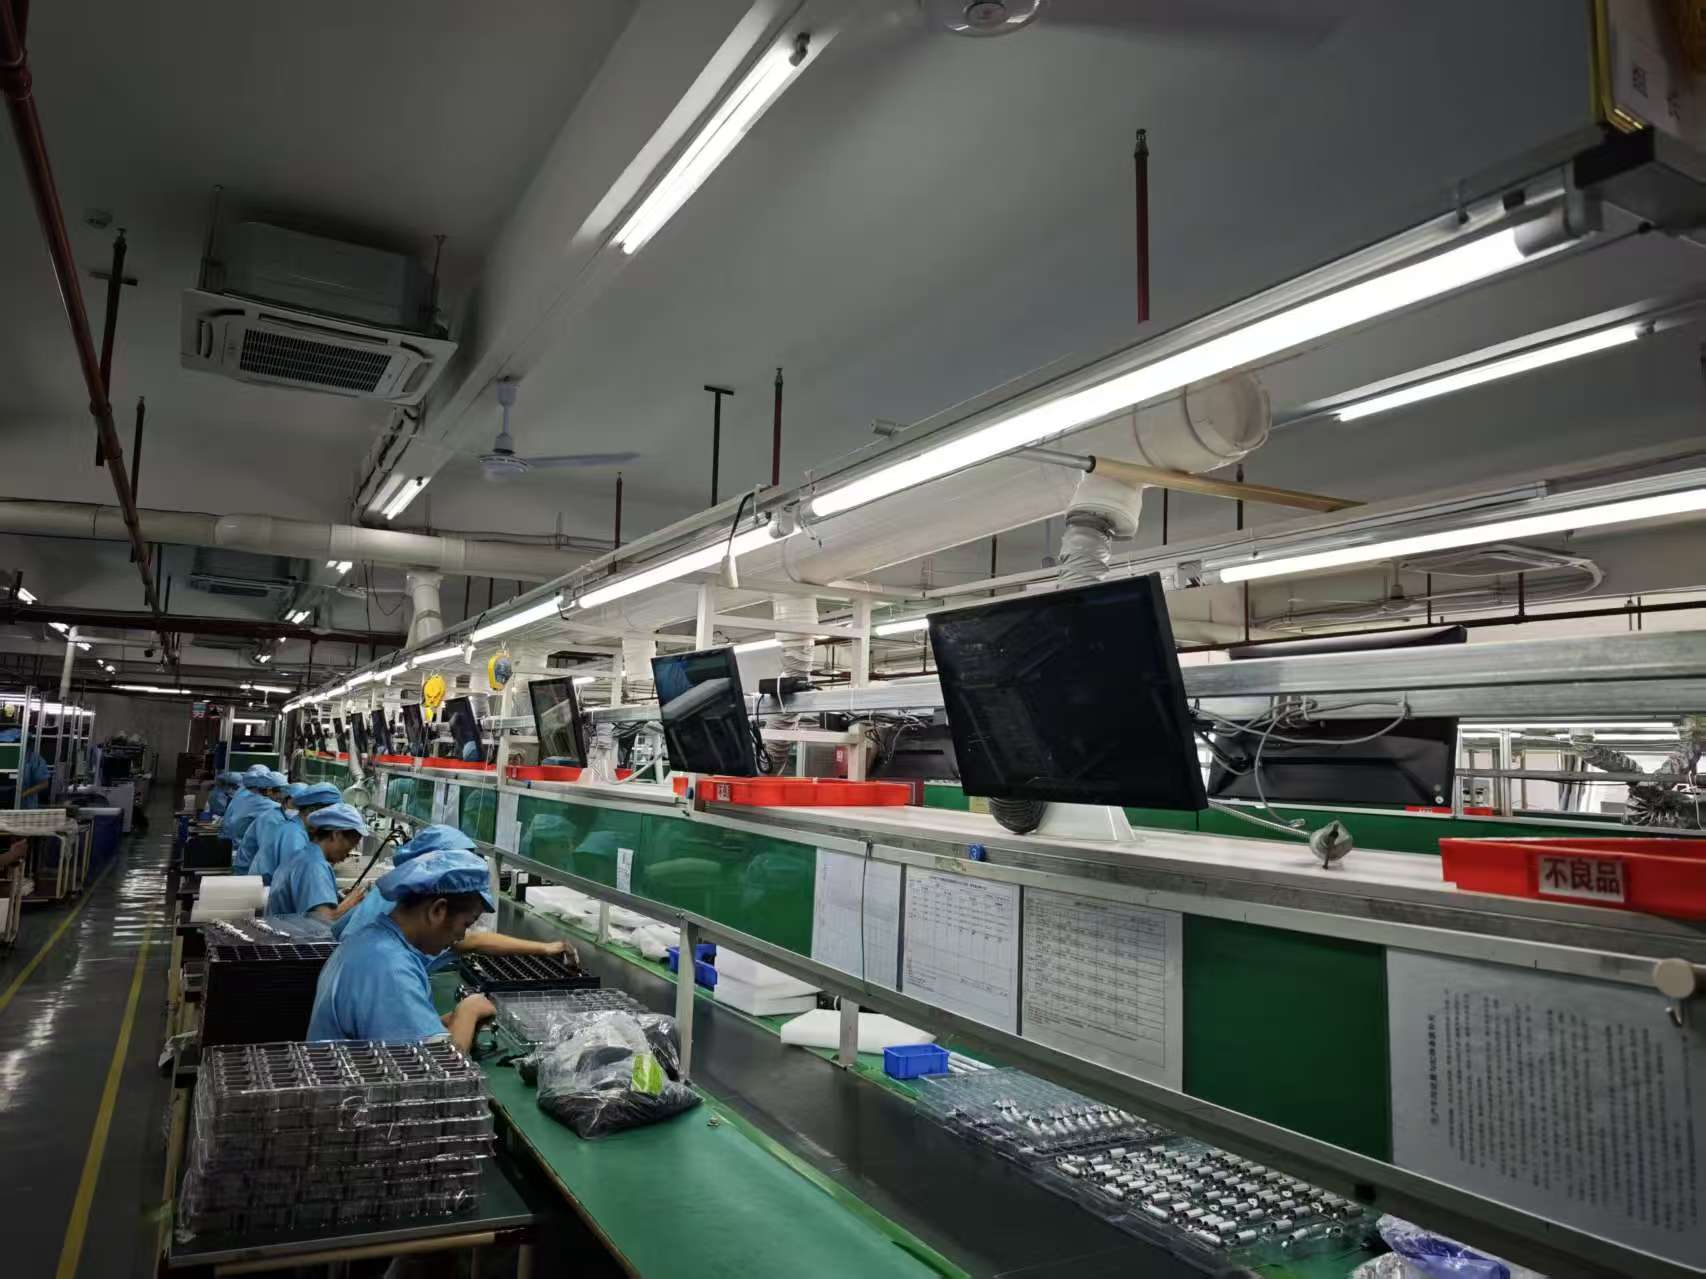
召回环节,要解决“该记多少”。把所有历史都塞进上下文,既贵又慢。常见策略是分层召回:先按时间衰减打分,再按业务相关性过滤,最后做摘要压缩。比如某电子厂假设场景中,Agent在回答“昨晚回流焊温度是否异常”时,只需要召回最近8小时该设备的数据和上一次相同产品的炉温曲线,而不是整月记录。
遗忘环节,最容易被忽略。工业数据有强时效性,半年前的排产逻辑可能已经因为换线而失效。设计上要支持TTL过期、重要性衰减和人工标记删除。没有遗忘机制的Agent,会越用越“固执”,把过时经验当真理。
三、制造业应用场景
假设一家汽配企业,压铸机换模频繁,每次换模后首件检验经常超差。如果Agent有记忆机制,它可以在第一次换模时记录模具编号、压射速度、模温、保压时间与首件结果的关系。第二次换同一套模具时,Agent主动提示“上次该模具在模温185度时首件合格,建议预热到该区间再试”。这就把老师傅的经验变成了可复用的记忆。
再假设某电子厂,SMT产线换料频繁。Agent可以记住每盘物料的料号、批次、飞达站位和抛料率。当某盘物料连续两班抛料率偏高时,Agent在下次上料前提醒“该批次物料在2号飞达上历史抛料率超阈值,建议换站位或提前校准”。这种记忆不是简单的报警,而是跨班次积累的统计记忆。
第三个场景是设备维修。假设一家注塑企业,某台机台反复出现油温报警。Agent可以记住每次报警前的油压曲线、冷却水流量和当时生产的产品型号。第三次报警时,Agent不再只报“油温高”,而是提示“前两次同型号生产时,冷却水流量低于阈值后15分钟出现油温报警,建议先查冷却水路”。科创致远在工业AI Agent的设计中,把这类维修记忆与ESOP(电子标准作业程序)联动,维修工单关闭时自动把有效处置步骤写回知识库,下次同类问题直接推送。
四、选型与实施落地建议
第一,先明确记忆的边界。不是所有数据都值得记。建议按“设备+产品+工艺参数+结果”四元组来定义最小记忆单元,避免把闲聊和无关日志都存进去。
第二,优先做短期记忆和程序性记忆。长期记忆的向量库建设成本高,可以先从单班次、单工单的上下文管理做起,让Agent先“记得住当前任务”。程序性记忆可以固化成工具调用模板,比如“查MES工单状态”固定走一个API,不需要每次重新推理。
第三,遗忘策略要可配置。建议给每类记忆设一个默认TTL,比如报警记录保留90天,工艺参数保留一年,人工标记的重要经验永久保留。同时允许工艺工程师手动“教”Agent记住或忘记某条经验。
第四,和现有系统解耦。记忆层最好独立于MES和SCADA,通过标准接口读写。这样换大模型或换MES时,记忆资产不丢失。科创致远在MES+AI架构中,把记忆层作为独立服务,累计3200余家终端的使用反馈表明,解耦设计让Agent的迭代速度明显快于绑定式方案。
第五,小场景验证。不要一上来就做全厂记忆。选一条产线、一类设备、一个班次做试点,观察Agent召回是否准确、遗忘是否合理、响应是否可接受。跑通后再横向复制。
五、趋势展望
第一个方向是多Agent记忆共享。未来产线上的排产Agent、质检Agent、维修Agent会共享一个记忆池,但各自有不同的读写权限。排产Agent写入的换线记录,维修Agent可以读,但不能改。这需要记忆机制支持细粒度权限和版本管理。
第二个方向是记忆与仿真结合。Agent记住的工艺参数,可以直接喂给数字孪生做验证,验证通过后再写回长期记忆。这样记忆不是静态日志,而是经过仿真筛选的“可信经验”。
第三个方向是边缘侧轻量记忆。很多工厂不希望所有数据上云,边缘盒子需要支持本地向量检索和摘要压缩。这对记忆机制的压缩率和检索速度提出了更高要求,也是科创致远在工业AI Agent方向持续投入的重点之一。
总的来说,AI Agent的记忆机制设计,本质是在“记住什么、记多久、怎么用”之间找平衡。制造业场景尤其看重可解释、可干预、可遗忘。谁把记忆层做扎实,谁的Agent才能真正从演示走向产线。
 产品方案
 预约演示
 价格咨询